Giảm chi phí LLM: dùng bộ phân loại rẻ để định tuyến giữa các model
Trong bài này
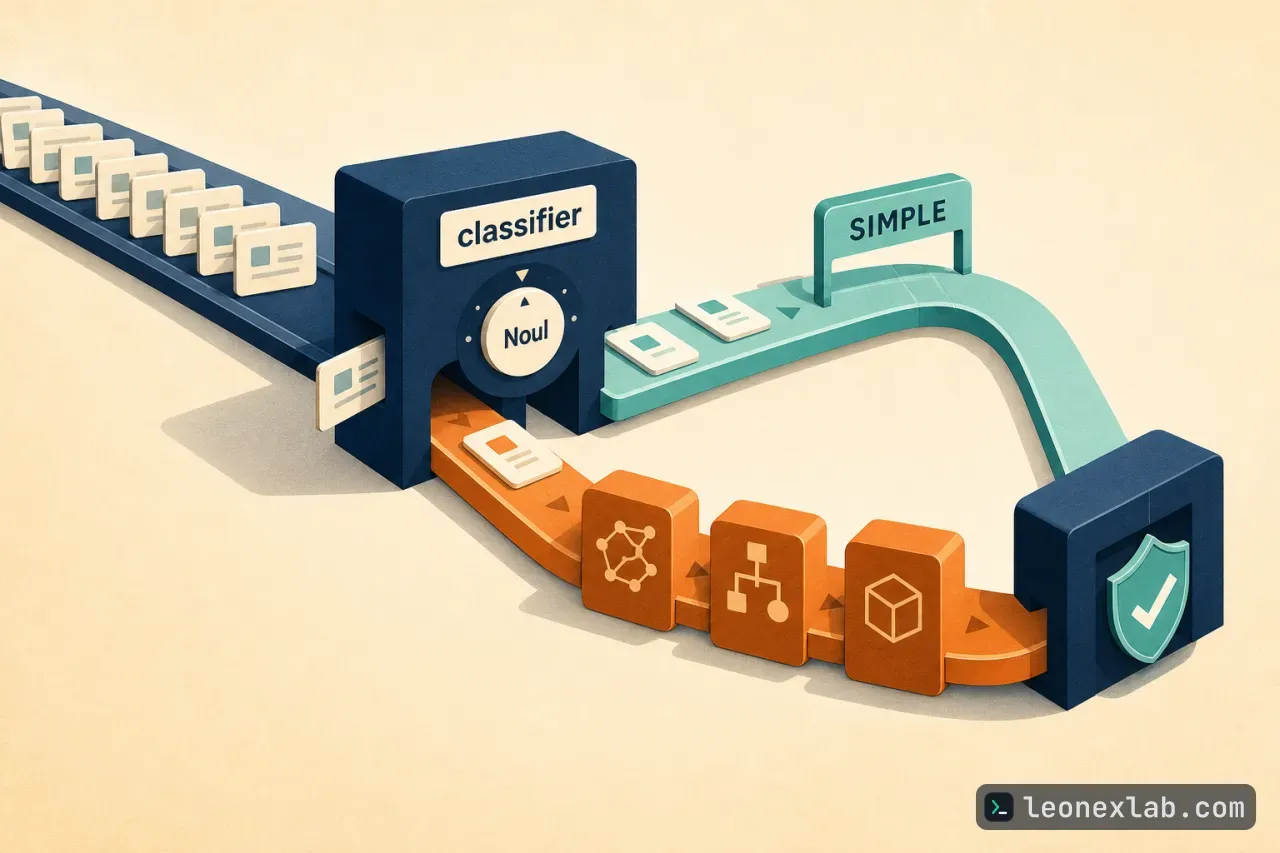
Giá theo token của các API đang giảm, nhưng hóa đơn cho các coding agent tự động vẫn tăng. Thước đo chi phối kinh tế khi chạy thực tế giờ là chi phí cho mỗi tác vụ thành công: tổng chi tiêu qua mọi vòng lặp, lệnh gọi công cụ, lần thử lại và lượt suy luận nội bộ, chia cho số tác vụ vượt qua bước kiểm chứng. Một thử nghiệm với 50 câu hỏi coding-agent được chấm tự động, chạy trên các API Gemini và Jev thật, cho thấy cách dùng một bộ phân loại (classifier) gần như miễn phí để định tuyến từng tác vụ đến cấu hình rẻ nhất mà vẫn cho kết quả đúng.
Vì sao cần lớp định tuyến nhẹ
Khi agent gọi cấu hình suy luận mức cao cho mọi quyết định nhỏ trong harness, chi phí suy luận sâu bị trả cho những câu hỏi mà cấu hình nhẹ đã trả lời chính xác. Để tránh khoản phí không cần thiết này, có thể thêm một lớp định tuyến nhẹ chặn các quyết định thường ngày trước khi chúng đến mô hình suy luận đắt đỏ.
Trong thử nghiệm, lớp này là bộ phân loại Jev của TypeSafe đặt trước các lệnh gọi mô hình của Google Antigravity. Jev là bộ phân loại đầu ra có cấu trúc, dành cho các pipeline ra quyết định thông lượng cao. Thay vì sinh văn bản từng token, nó đánh giá các primitive phân loại trong một lượt forward pass duy nhất: Choice (chọn từ một danh sách), Score (điểm số) hoặc Noul (xác suất từ 0 đến 1 cho một mệnh đề nhị phân). Google không có quan hệ đối tác với TypeSafe và nội dung này không phải sự quảng bá cho TypeSafe hay sản phẩm của hãng.
Jev chỉ là một ví dụ về bộ phân loại nhẹ. Cùng mẫu định tuyến có thể xây bằng bộ phân loại khác, kể cả loại của Google. Codelab Getting started with discriminative models chạy cùng kiểu classifier trên DiffusionGemma, mô hình open-weights của Google DeepMind, ngay trong project Google Cloud của người dùng. Một máy chủ mã nguồn mở cung cấp cùng API ở phía trước, nên mã định tuyến chỉ cần đổi endpoint. Vì kết quả trong thử nghiệm đến từ Jev, cần tự đo độ chính xác và độ trễ trên tác vụ của mình trước khi chuyển đổi, và lưu ý mô hình tự host được tính phí theo giờ GPU thay vì theo token.
Định tuyến bằng classifier so với heuristic regex
Cách làm ngây thơ là đặt một câu hỏi Choice rộng: tác vụ này đơn giản hay phức tạp. Khi thử trên 16 tác vụ, Jev xếp gần như tất cả vào nhóm đơn giản, kể cả những bài cần lần vết LRU cache hay lũy thừa modular. Tài liệu của TypeSafe cảnh báo đúng anti-pattern này: nếu câu hỏi cân nhắc nhiều yếu tố hoặc đòi hỏi phán đoán tổng quát, hãy tách thành các phép kiểm tra nguyên tử.
Khi thay câu hỏi rộng bằng một câu hỏi Noul nguyên tử, việc phân tách được cải thiện ngay. Câu hỏi hỏi liệu việc trả lời có cần thực hiện nhiều hơn một phép tính tuần tự, bước mô phỏng hoặc suy luận logic, thay vì chỉ một lần tra cứu trực tiếp, kiểm tra định dạng hoặc phân loại một bước. Đoạn code từ thử nghiệm:
def call_jev(question_text):
 body = {
 "state": question_text,
 "model": "jev-latest",
 "questions": {
 "multi_step": {
 "type": "noul",
 "instructions": (
 "Answering this requires performing more than one "
 "sequential calculation, simulation step, or logical "
 "deduction, rather than a single direct lookup, format "
 "check, or one-step classification."
 ),
 }
 },
 }
 # Send the request above to the classifier's API.
 # response.answers["multi_step"].noul is the probability used to route.
Trên 16 tác vụ ban đầu, Jev khớp nhãn độ khó gán tay ở 13 trên 16 tác vụ trong lần chạy đầu và 14 trên 16 ở lần thứ hai. Với câu hỏi liệu có cần API classifier khi đã có thể viết heuristic regex và độ dài prompt không tốn phí, heuristic cục bộ (khớp các từ như sequence, modulo, race condition hoặc nâng cấp mọi prompt trên 35 từ) đạt 15 trên 16, tức 93,8%, trên chính các câu hỏi dùng để viết luật.
Để kiểm tra heuristic trước lưu lượng thực tế, đoạn code được đóng băng không sửa một ký tự và bổ sung 34 tác vụ held-out chưa từng thấy, thuộc bảy nhóm: trích xuất dữ kiện, kiểm tra schema, phân loại ngắn, kiểm tra code một bước, lần vết mô phỏng trạng thái, chuỗi toán hoặc logic, và lỗi tinh tế về ngữ nghĩa ngôn ngữ.
maxOutputTokens là trần, không phải nút chỉnh ngân sách suy luận
Một sai lầm phổ biến khi xây fast-path router là cho rằng đặt maxOutputTokens thấp trên mô hình suy luận sẽ khiến nó tốn ít hơn cho tác vụ dễ. Dữ liệu 50 câu hỏi cho thấy giả định này không đúng. Khi so sánh gemini-3.8-flash với maxOutputTokens=300 và với maxOutputTokens=4096, giữ nguyên thinkingConfig mặc định của API, hai cấu hình tiêu tốn lượng thinking token gần như giống hệt nhau trên 27 tác vụ mà Jev gán nhãn SIMPLE.
Vì vậy, router của Jev gửi tác vụ dễ đến mô hình bị giới hạn và tác vụ khó đến Flash thường tuy đúng cả 50 câu, vẫn tốn nhỉnh hơn và chậm hơn việc dùng Flash thường cho mọi thứ. Nếu lựa chọn rẻ không thực sự khiến mô hình suy nghĩ ít hơn trên tác vụ dễ, không router nào tiết kiệm được tiền, kể cả router hoàn hảo và miễn phí.
So Jev với thiết lập mạnh nhất không dùng router
Cách hiển nhiên để giảm chi phí suy luận là yêu cầu mô hình nghĩ ít hơn. Vòng thử nghiệm thứ hai dùng hai lựa chọn nhẹ hơn: Flash-Lite, vốn không suy luận theo mặc định, và Gemini 3.8 Flash với mức thinking đặt ở low. Kết quả được ghép từng câu hỏi vào cùng tệp kết quả. Về thời gian, phần lớn thời gian của router nằm ở các lệnh gọi Flash-Lite và Flash, được đo cùng lần chạy và cùng khung thời gian với baseline Flash thường nên so sánh tốc độ giữa chúng là công bằng. Quyết định của chính Jev chỉ chiếm phần nhỏ và lấy từ vòng đầu, nên các so sánh tốc độ với Flash mặc định hoặc Pro trộn hai vòng và chỉ mang tính tương đối.
Thiết lập mạnh nhất không dùng router là Gemini 3.8 Flash ở mức thinking thấp, giải đúng cả 50 tác vụ; đó là con số router phải vượt. Router Jev đã vượt: nó gửi mọi tác vụ đến Flash-Lite trước và chỉ nâng cấp những gì Jev gắn cờ phức tạp. Router cũng giải đúng 50 tác vụ và có thể giảm cả chi phí lẫn thời gian phản hồi so với chạy thinking thấp cho mọi thứ. Với prompt ngắn như vậy, chênh lệch chi phí mỗi tác vụ nhỏ, nên với agent tương tác, thời gian chờ ngắn hơn mới là lợi ích lớn hơn.
Riêng Flash-Lite trả lời mọi tác vụ đơn giản trong nửa giây nhưng trượt 6 trên 25 tác vụ khó; Jev gắn cờ phức tạp cho cả 6 với độ tin cậy cao và nâng cấp chúng, đưa chi phí gần mức của một router hoàn hảo.
Heuristic từ khóa rẻ hơn, nhưng chỉ vì sai: nó gửi 5 tác vụ khó đến Flash-Lite, 2 tác vụ thất bại, kết quả 48 trên 50.
Nâng cấp lên cấu hình nặng hơn không đáng ở đây: định tuyến tác vụ khó đến Flash với thinking mặc định rẻ hơn chạy thinking mặc định ở mọi nơi, nhưng vẫn đắt hơn chạy thinking thấp cho mọi thứ, vốn đã giải đúng cả 50. Đích nâng cấp nặng hơn chỉ hợp lý khi mức thấp bắt đầu thất bại.
Giới hạn của thử nghiệm: mỗi thiết lập chỉ chạy một lần, 50 prompt có độ khó gán tay và việc chấm điểm tự động đơn giản.
Giá theo token không nói lên toàn bộ câu chuyện
Định tuyến và caching kéo theo hai hướng ngược nhau. Các prompt thử nghiệm là tác vụ ngắn, độc lập, nơi router Jev giúp giảm cả chi phí lẫn thời gian phản hồi. Coding agent thực tế thường khác: chúng gửi cùng một khối ngữ cảnh lớn ở mỗi lượt, như bản đồ repository và định nghĩa công cụ. Agent Platform Context Caching lưu khối này để chi phí gửi lại giảm từ 75% đến 90%. Tuy nhiên, cache thuộc về một mô hình. Nếu agent chuyển qua lại giữa Flash-Lite và Flash từng lượt, nó hoặc phải giữ hai cache hoặc mất khoản giảm giá. Cách chia thực tế: định tuyến các tác vụ ngắn, độc lập như phân tích log hay kiểm tra schema, và giữ các lượt dài, nặng ngữ cảnh trên một mô hình.
Cũng cần chọn mô hình phù hợp với khối lượng công việc. Gemini 3.1 Pro được xây cho suy luận sâu, nhiều bước, và mang chiều sâu đó đến mọi yêu cầu, kể cả các tra cứu ngắn không cần đến. Với khối lượng công việc chủ yếu là kiểm tra và trích xuất nhanh, cấu hình Flash phù hợp hơn và nên để dành Pro cho các tác vụ cần chiều sâu suy luận. Mỗi cấu hình mô hình còn có thể áp dụng cài đặt an toàn khác nhau cho prompt liên quan đến bảo mật: trong lần chạy này, cấu hình Pro từ chối hai prompt rà soát bảo mật code ngắn mà Flash trả lời. Nếu agent thực hiện rà soát bảo mật, nên thử các prompt đó trên cấu hình dự định dùng.
Ba quy tắc thực hành
Bắt đầu với Flash ở mức thinking thấp trước khi xây router. Cấu hình này giải đúng cả 50 tác vụ và rẻ hơn đáng kể so với thiết lập mặc định. Hạ giới hạn output token không thay thế được việc này vì nó không làm mô hình nghĩ ít hơn trên tác vụ dễ; hãy đặt trực tiếp thinkingLevel: "LOW".
Dùng Jev để định tuyến tác vụ ngắn, độc lập: gửi tác vụ đơn giản đến Flash-Lite và tác vụ khó đến Flash ở thinking thấp, mỗi yếu tố hỏi một câu có/không đơn giản. Trong thử nghiệm, cách này giúp giảm chi phí và thời gian phản hồi so với chạy Flash ở thinking thấp cho mọi thứ, và gần với một router hoàn hảo. Giữ các lượt dài, nặng ngữ cảnh trên một mô hình để caching tiếp tục hoạt động. Với khối lượng lớn trên data warehouse, mẫu cascade BigQuery và Cloud Run của Jeff Nelson áp dụng cùng ý tưởng.
Đo thứ agent thực sự tiêu tốn: gửi trace và số thinking token của agent vào Cloud Logging và BigQuery để thấy tác vụ nào đẩy chi phí lên, đồng thời phát hiện việc bị cắt cụt hoặc thử lại làm phình chi phí.
Tóm lại, cách chạy agent tiết kiệm nhất là khớp từng tác vụ với mô hình phù hợp: bắt đầu bằng mô hình nhanh ở cấu hình nhẹ, rồi thêm một bộ phân loại nhỏ gần như miễn phí như Jev để chỉ gửi tác vụ khó đến mô hình mạnh hơn, và hỏi các câu có/không đơn giản thay vì một câu rộng. Mọi lựa chọn nên được đánh giá theo chi phí cho mỗi tác vụ làm đúng, không phải theo từng token.
Điểm chính
Nguồn tham khảo
Các nguồn mà bài viết này dựa vào.