Kubernetes chuyển hẳn sang cgroup v2: những điều cần biết
Trong bài này
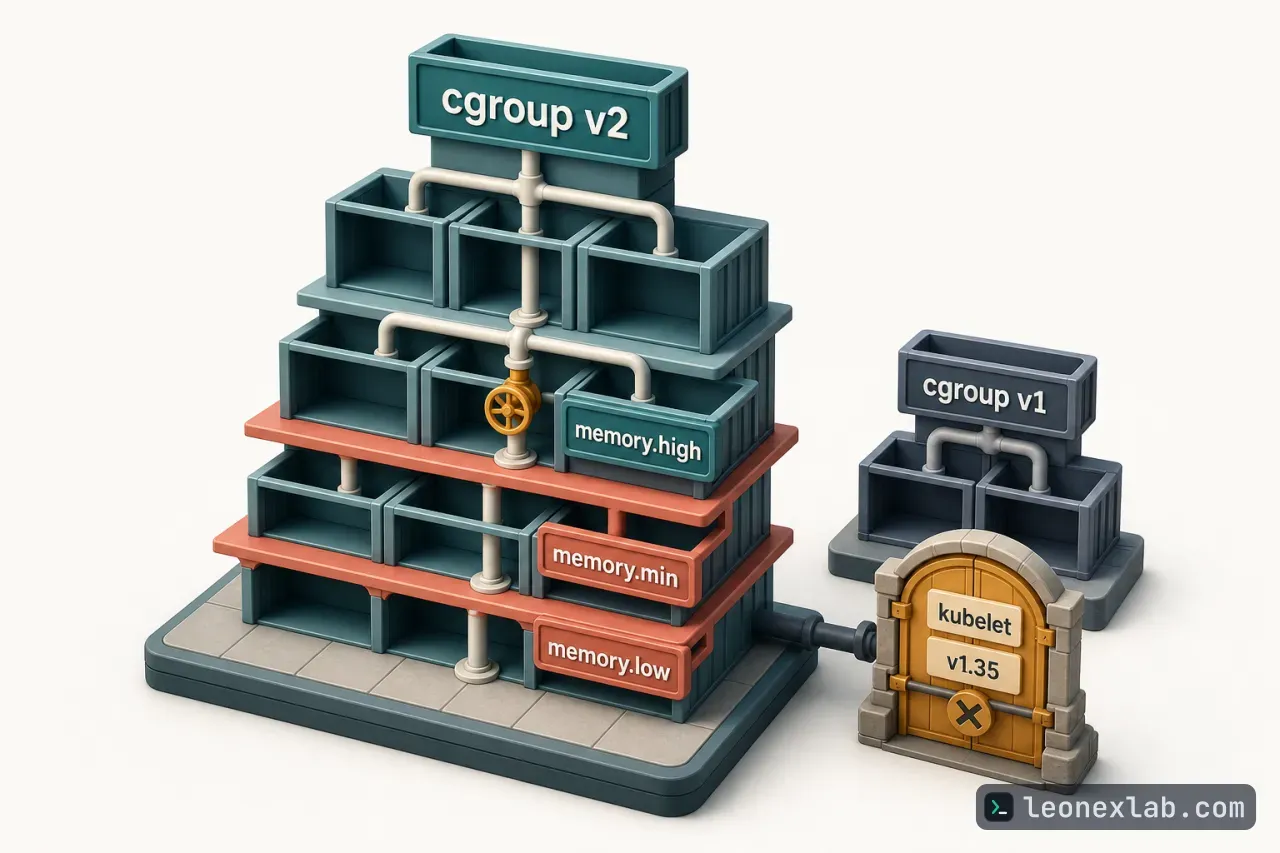
cgroups (control groups) là tính năng của nhân Linux dùng để quản lý tài nguyên hệ thống, và Kubernetes dựa vào chúng để cấp phát CPU, bộ nhớ cho container sao cho các ứng dụng không làm phiền nhau. Cgroup v1 hiện đã bị deprecated: từ Kubernetes v1.35, kubelet mặc định không khởi động trên node dùng cgroup v1. Bài viết tóm tắt lý do nên chuyển sang cgroup v2, các cải tiến đi kèm, yêu cầu để áp dụng và những lệnh hữu ích khi kiểm tra.
Lộ trình ngừng hỗ trợ cgroup v1
Từ Kubernetes v1.31, việc hỗ trợ quản lý cgroup v1 đã chuyển sang chế độ maintenance mode, còn cgroup v2 ổn định từ Kubernetes v1.25. So với v1, cgroup v2 có một hệ phân cấp thống nhất (single unified hierarchy), giao diện nhất quán hơn và nền tảng vững hơn cho cô lập tài nguyên cũng như các tính năng quản lý tài nguyên hiện đại.
Từ Kubernetes v1.35, tùy chọn failCgroupV1 mặc định là true, nên kubelet không khởi động trên node cgroup v1. Quản trị viên có thể tạm đặt failCgroupV1: false trong tệp cấu hình kubelet, nhưng việc gỡ bỏ sẽ diễn ra theo chính sách deprecation của Kubernetes. Công việc gỡ bỏ tiếp theo được theo dõi trong KEP-5573. Trong Kubernetes 1.36, cgroup v1 vẫn là phương án dự phòng và được lên lịch gỡ bỏ ở Kubernetes v1.38.
Hành động cần làm phụ thuộc vào phiên bản đang chạy:
Với bản cũ hơn v1.35: chuyển mọi node Linux sang cgroup v2 trước khi nâng cấp, hoặc lên kế hoạch dùng tạm failCgroupV1: false.
Với v1.35 trở lên: xác nhận mọi node Linux chạy cgroup v2, hoặc cố ý giữ cấu hình ghi đè. Theo cấu hình mặc định, node cgroup v1 còn sót lại sẽ lỗi ngay lúc kubelet khởi động.
Với cụm do kubeadm quản lý: bước kiểm tra preflight SystemVerification trả về lỗi trong kubeadm init, kubeadm join và kubeadm upgrade khi phát hiện cgroup v1 cùng kubelet v1.35 trở lên; với kubelet cũ hơn thì vẫn chỉ là cảnh báo.
Hạn chế của cgroup v1 và cải tiến ở cgroup v2
Memory QoS xuất hiện dạng alpha từ Kubernetes v1.22, được cập nhật ở v1.27 và vẫn là alpha ở v1.36, nhưng nay tách việc điều tiết bộ nhớ (throttling) khỏi việc dành riêng bộ nhớ (reservation) và thêm tiered memory protection. Tính năng này chỉ có trên node Linux dùng cgroup v2 vì dựa vào memory controller của cgroup v2: memory.high để điều tiết, memory.min và memory.low để bảo vệ cứng và mềm khi bật tiered reservation. Cgroup v1 không thể cung cấp mô hình bảo vệ này.
Bật feature gate MemoryQoS sẽ áp dụng memory.high cho container Burstable; ngưỡng tính từ request, limit và memoryThrottlingFactor (mặc định 0.9).
memoryReservationPolicy: None là mặc định và không ghi memory.min hay memory.low.
memoryReservationPolicy: TieredReservation ánh xạ memory request của Pod Guaranteed sang memory.min (bảo vệ cứng) và của Pod Burstable sang memory.low (bảo vệ mềm); Pod BestEffort không được bảo vệ nào.
Kubelet cung cấp các metric Alpha về tổng memory.min và memory.low đã dành riêng trên node.
Nên dùng kernel 5.9 trở lên; trên kernel cũ hơn, memory.high reclaim có thể gây livelock đã biết, và từ v1.36 kubelet ghi cảnh báo khi Memory QoS bật trên kernel bị ảnh hưởng.
Ví dụ cấu hình để bật bảo vệ theo tầng:
apiVersion : kubelet.config.k8s.io/v1beta1
 kind : KubeletConfiguration
 featureGates :
 MemoryQoS : true
 memoryReservationPolicy : TieredReservation
 memoryThrottlingFactor : 0.9
Kubernetes khuyến nghị không bật tính năng Alpha trong production. Nếu vẫn thấy tiered reservation hữu ích cho nền tảng, cần kiểm thử cấu hình và tính đến lượng bộ nhớ bị dành riêng cứng trước khi bật.
Về xử lý OOM, trên node cgroup v2 kubelet mặc định singleProcessOOMKill là false. Nhờ đó memory.oom.group được đặt cho mỗi cgroup của container, và khi xảy ra OOM thì mọi tiến trình trong container bị kill cùng lúc, thay vì để lại một container đa tiến trình hoạt động dở dang. Chỉ đặt singleProcessOOMKill: true nếu cần hành vi tương thích cgroup v1, tức nhân có thể kill từng tiến trình một. Hành vi này giới hạn ở cgroup của container, không phải toàn Pod. Ngoài ra, cgroup.kill là giao diện quản trị riêng: ghi 1 vào đó sẽ gửi SIGKILL tới mọi tiến trình trong cgroup và các cgroup con, và nó không cấu hình hành vi OOM. Memory controller của cgroup v2 còn cung cấp bộ đếm memory.events để hệ thống giám sát và trình quản lý OOM ở userspace quan sát.
Các cải tiến khác đi kèm cgroup v2
Rootless: ở cgroup v1, ủy quyền controller cho container ít đặc quyền có thể nguy hiểm; cgroup v2 hỗ trợ delegation chính thức, và đa số triển khai rootless container dựa vào systemd để ủy quyền controller v2 cho người dùng không phải root. Cơ chế này tách biệt với Pod user namespaces, vốn đã stable ở Kubernetes v1.36 và có các điều kiện tiên quyết về filesystem, kernel, CRI runtime và OCI runtime cần kiểm tra.
eBPF: device controller của cgroup v2 không có tệp giao diện và được xây dựng trên cgroup BPF. Cilium gắn các chương trình BPF cgroup cho socket-based load balancing, với cgroup root mặc định là /run/cilium/cgroupv2.
Pressure Stall Information (PSI): báo cáo mức tranh chấp CPU, bộ nhớ và I/O ở cấp node, Pod và container. Trên cụm được hỗ trợ, kubelet bật PSI mặc định (KubeletPSI đã stable và bị khóa bật). PSI cần cgroup v2, Linux 4.20 trở lên, CONFIG_PSI=y và kernel không khởi động với psi=0; dữ liệu có qua Summary API và /metrics/cadvisor.
Chuyển đổi CPU weight: cgroup v1 dùng cpu.shares còn cgroup v2 dùng cpu.weight. Các OCI runtime mới dùng phép quy đổi phi tuyến cải tiến, giữ nguyên mức ưu tiên mặc định và cho các CPU request nhỏ độ mịn dùng được cao hơn. Thay đổi nằm ở OCI runtime chứ không phải Kubernetes, có trong crun v1.23 và runc v1.3.2; sau khi nâng cấp runtime, công cụ giám sát hoặc policy dự đoán chính xác giá trị cpu.weight có thể cần cập nhật.
Cập nhật tài nguyên tại chỗ: in-place Pod vertical scaling đã stable ở Kubernetes v1.35; ở v1.36, tính năng này cho Pod-level resources được bật mặc định ở mức Beta. Kubelet điều phối thay đổi giữa cgroup cấp Pod và cấp container, và để thực thi tổng hợp chính xác thì cần cgroup v2.
Khi chuyển đổi, cần cập nhật phần mềm đọc trực tiếp cgroup filesystem. Hướng dẫn migration khuyến nghị cAdvisor v0.43.0 trở lên và liệt kê các phiên bản Java, Node.js và automaxprocs tương thích.
Điều kiện để áp dụng cgroup v2
Cần dùng phiên bản Kubernetes hỗ trợ quản lý cgroup v2; hỗ trợ này ổn định từ v1.25 và có trong mọi bản đang được hỗ trợ. Các yêu cầu cụ thể:
Có ít nhất một node Linux, vì cgroup là khái niệm chỉ có trên Linux.
Hệ điều hành phải chạy với cgroup v2 được bật.
Kernel từ 5.8 trở lên (khuyến nghị 5.9 trở lên khi dùng Memory QoS).
Container runtime hỗ trợ cgroup v2: containerd v1.4 trở lên (dùng containerd v2.0 trở lên để tự động nhận diện cgroup driver) hoặc CRI-O v1.20 trở lên.
Kubelet và container runtime phải cùng cấu hình đúng cgroup driver.
Về lịch sử kernel: khi Kubernetes ra mắt năm 2014 chỉ có cgroup v1. Cgroup v2 xuất hiện lần đầu ở Linux 4.5 năm 2016 với các controller io, memory và pids; Linux 4.15 thêm cpu controller và PSI bắt đầu từ Linux 4.20. Dự án không khuyến nghị dùng cgroup v2 với kernel cũ hơn 5.2 do thiếu hỗ trợ task freezer ở cấp cgroup. Mức tối thiểu được ghi là 5.8, vì tệp cpu.stat cấp hệ thống của root cgroup được thêm ở Linux 5.8. Bản sửa livelock memory.high cho Memory QoS có từ Linux 5.9, còn memory.peak được thêm ở Linux 5.19.
apiVersion : kubelet.config.k8s.io/v1beta1
 kind : KubeletConfiguration
 cgroupDriver : systemd
Công cụ và lệnh để kiểm tra, gỡ lỗi
stat -fc %T /sys/fs/cgroup/ : kiểm tra cgroup v2 đã bật chưa; kết quả cgroup2fs nghĩa là đã bật.
systemctl list-units 'kube*' --type=slice hoặc --type=scope : liệt kê các unit liên quan Kubernetes mà systemd đang giữ trong bộ nhớ.
bpftool cgroup list /sys/fs/cgroup/* : liệt kê các chương trình gắn vào cgroup.
systemd-cgls /sys/fs/cgroup/* : hiển thị đệ quy nội dung control group.
systemd-cgtop : xem các control group dùng nhiều tài nguyên nhất.
tree -L 2 -d /sys/fs/cgroup/kubepods.slice : xem các thư mục cgroup liên quan tới Pod.
Để kiểm tra giới hạn CPU hoặc bộ nhớ của Pod đã được áp vào tệp cgroup hay chưa, nên đi từ đối tượng API xuống node. Trước hết xác định node, rồi so sánh tài nguyên mong muốn trong spec với giá trị đã áp dụng trong status, vì in-place resize có thể làm hai bên lệch nhau:
kubectl get pod <pod-name> -n <namespace> \
 -o jsonpath = '{.spec.nodeName}{"\n"}'
Trên node đó, với quyền root, systemd cgroup driver và cgroup v2 (cần thêm jq), dùng nhãn của kubelet để xác định đúng container, vì tên container một mình không duy nhất trên node; dùng crictl ps -a nếu container không chạy:
CONTAINER_ID = $( crictl ps \
 --label io.kubernetes.pod.namespace = <namespace> \
 --label io.kubernetes.pod.name = <pod-name> \
 --name <container-name> -q | head -n1 )
Sau đó đọc các tệp cgroup của container, gồm cpu.weight, cpu.max và memory.max. Giá trị cpu.max cho giới hạn CPU dạng quota và period, còn memory.max cho giới hạn bộ nhớ; khi bật MemoryQoS còn có memory.high, memory.min và memory.low. Không coi info.runtimeSpec.linux.cgroupsPath là đường dẫn hệ thống tệp khi runtime dùng systemd driver, vì đó là đường dẫn unit của systemd chứ không phải thư mục dưới /sys/fs/cgroup.
Điểm chính
Nguồn tham khảo
Các nguồn mà bài viết này dựa vào.