Ổn định ứng dụng ở quy mô lớn bằng phòng thủ nhiều lớp
Trong bài này
Vì sao crash trên di động đắt đỏ và khó lường
Riêng trên Android, ứng dụng có hàng triệu dòng code, nhiều kỹ sư đưa code vào mỗi bản phát hành theo chu kỳ hằng tuần. Mỗi tuần có rất nhiều merge request từ nhiều nhóm sản phẩm, trong đó không ít tính năng nằm sau feature flag (cờ tính năng, bật tắt độc lập với bản phát hành). Bất kỳ thay đổi nào cũng có thể gây crash. Thông thường stack trace chỉ thẳng tới thay đổi và nhóm chịu trách nhiệm; trường hợp khó là crash không có stack trace dùng được, chẳng hạn crash native thiếu debug symbol, khi phải đối chiếu mốc phát hành, lịch bật flag và metadata của phiên.
Chi phí trên di động cũng cao hơn web. Bản sửa web lên trong vài phút, còn crash đã phát hành thì nằm lại trên thiết bị người dùng. Không phải ai cũng bật tự động cập nhật, nên cho tới khi force update tới nơi, một số người có thể chạy bản lỗi trong nhiều tháng. Crash làm xấu trải nghiệm, kéo tụt crash-free session rate và có thể ảnh hưởng thứ hạng trên Google Play. Nếu nghiêm trọng tới mức cần hotfix, nhóm còn phải chuẩn bị một bản build ngoài chu kỳ, mất thời gian của công việc đã lên kế hoạch.
Phòng ngừa: lint và nhiều tầng kiểm thử
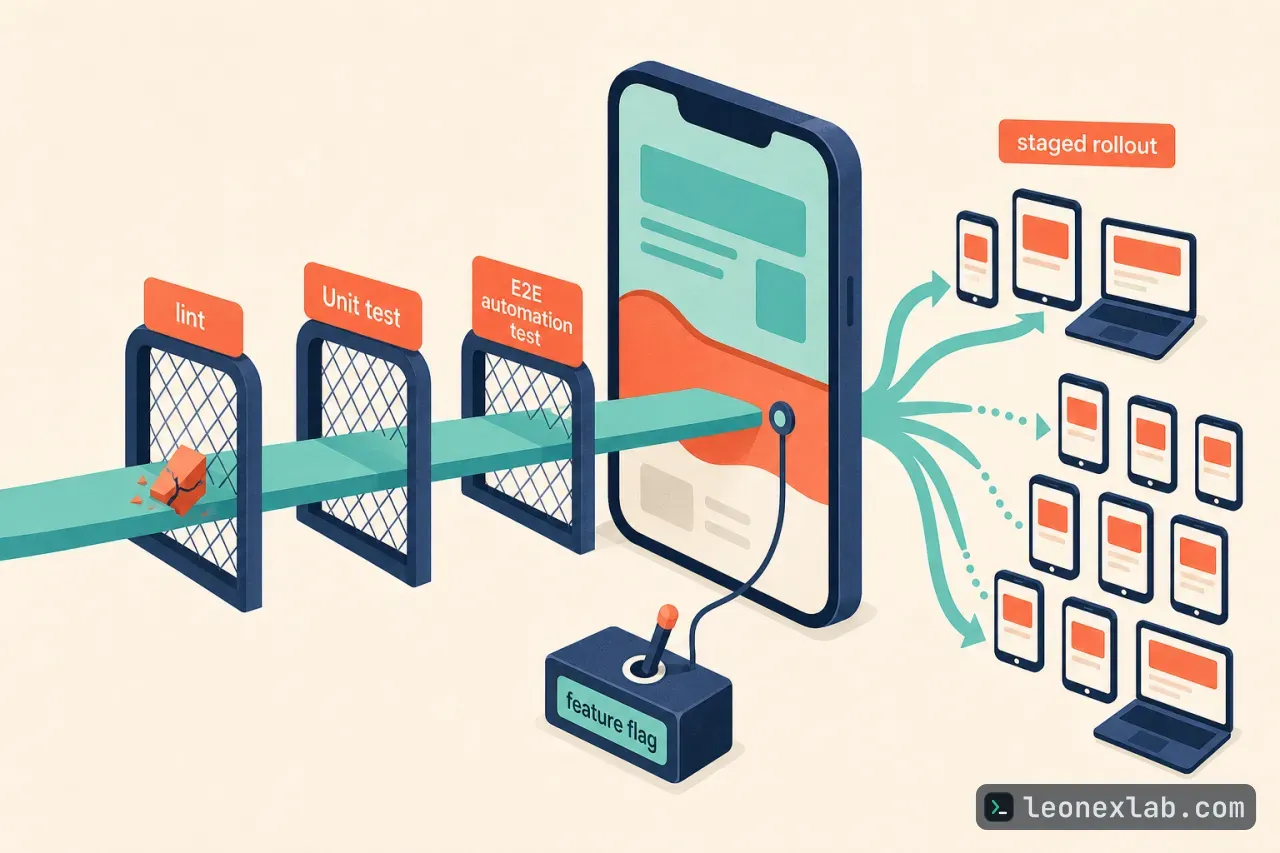
Lint là lớp rẻ nhất: phân tích tĩnh để gắn cờ mẫu code không an toàn, dùng sai API và các nguy cơ crash trước khi code chạy. Android dùng Android Lint, iOS dùng SwiftLint; cả hai chạy trong CI trên mọi merge request và phát hiện mức nghiêm trọng cao sẽ chặn merge. Lỗi có sẵn từ trước không chặn merge request: Android ghi chúng vào lint baseline, còn SwiftLint trên iOS chỉ báo cáo các dòng mà merge request thay đổi. Nhờ vậy merge request chỉ thất bại vì những phát hiện do chính nó tạo ra.
Các rule lint đến từ ba nguồn:
Rule tùy biến càng quan trọng khi lập trình có AI hỗ trợ tăng lên. Một trợ lý có thể viết code trông đúng về tổng thể mà không biết mẫu nào từng làm crash ứng dụng. Rule tùy biến biến các bài học đó thành kiểm tra áp dụng như nhau cho code viết tay và code do AI sinh ra. Lint thường xuyên chặn các merge request mang lỗi mức Fatal, loại thường làm ứng dụng crash ngay hoặc không chạy được.
Unit test: kiểm tra tính đúng đắn của logic nghiệp vụ ở mức hàm và lớp, chặn lỗi logic trước khi merge.
UI component test: kiểm tra hiển thị và tương tác của từng thành phần giao diện, bắt crash do lỗi render hoặc lệch state; giống unit test, chúng chạy trước khi merge trên mọi merge request.
E2E automation test: bảo đảm các hành trình quan trọng của người dùng, chạy theo lịch của từng nhóm và trên mọi release train.
QA manual testing: thử nghiệm khám phá trên thiết bị thật cho tính năng mới và thay đổi lớn, cộng một đợt regression đầy đủ ở mỗi bản phát hành, bắt các trường hợp biên mà automation bỏ sót.
Cổng phát hành: GEA, staged rollout và feature flag
Grab Early Access (GEA) là bản build truy cập sớm của Grab, đóng vai trò cổng chất lượng bắt buộc trong mỗi chu kỳ phát hành, kéo dài một tuần trước production. Build GEA được theo dõi crash liên tục; crash mới xuất hiện trong thời gian này tự động tạo ticket giao cho nhóm phụ trách, và lỗi do người dùng nội bộ báo, gồm lỗi chức năng, cũng được tạo ticket tương tự. Các nhóm phải giải quyết mọi vấn đề chặn trước khi bản phát hành tiến tới production. Tệp người dùng GEA đủ lớn để lộ ra các trường hợp biên thực tế mà test tự động bỏ sót, nhưng đủ nhỏ để vấn đề được khoanh vùng trước khi tới người dùng production.
Khi bản phát hành vào production, nó gặp sự đa dạng của thế giới thực mà môi trường kiểm thử nội bộ không mô phỏng được: hàng nghìn mẫu thiết bị, phiên bản OS, cấu hình nhà mạng và thói quen sử dụng. Hai cơ chế vận hành ở cổng này: giám sát staged rollout để hạn chế phạm vi ảnh hưởng, và feature flag để tách việc kích hoạt tính năng khỏi việc triển khai.
Mỗi bản phát hành được mở dần trong khoảng một tuần, bắt đầu từ một tỷ lệ nhỏ người dùng rồi mở rộng từng bước. Một monitor riêng theo dõi crash rate của phiên bản mới một cách tách biệt, vì regression của bản mới có thể bị che trong số liệu tổng hợp khi các bản cũ ổn định chiếm đa số. Nếu crash rate bất thường ở bất kỳ thời điểm nào, hệ thống tự động tạm dừng bản phát hành; rollout chỉ tiếp tục khi nhóm phụ trách xem xét và xác nhận rõ ràng. Nhờ đó regression chỉ ảnh hưởng một phần nhỏ người dùng thay vì lan ra toàn bộ.
Trong những tháng gần đây, nhiều đợt rollout Android bị tạm dừng để on-call xem xét. Phần lớn được tiếp tục sau điều tra: hoặc tín hiệu hóa ra là nhiễu, hoặc crash nằm sau một feature flag có thể tắt mà không cần build mới. Một số ít dừng ở giai đoạn đầu cho tới khi có hotfix. Monitor được chỉnh nhạy có chủ đích, vì một rollout bị dừng chỉ tốn vài giờ để sửa còn một regression bị bỏ sót có thể tốn nhiều tuần.
Về feature flag, mọi tính năng mới quan trọng đều phát hành sau flag. Cách này cho phép mở dần, theo dõi crash rate ở từng bước và tắt ngay tính năng nếu crash rate vượt ngưỡng, không cần chờ chu kỳ phát hành kế tiếp. Với đội phát hành hằng tuần, kill switch là thứ giúp lặp nhanh mà vẫn an toàn, đồng thời là đòn bẩy đầu tiên khi sự cố đã tới production.
Ứng phó khi crash lọt vào production
Không lớp phòng ngừa nào hoàn hảo. Flag từ xa cấu hình sai có thể mở ra đường chạy bất ngờ, bản cập nhật OS của nhà sản xuất thiết bị có thể đổi hành vi hệ thống, hoặc một lỗi chỉ xuất hiện với tổ hợp trạng thái thiết bị và thao tác người dùng nhất định. Lúc đó mục tiêu chuyển từ phòng ngừa sang kiềm chế, ưu tiên tốc độ phát hiện, cầm máu và độ chính xác của chẩn đoán.
Grab giám sát crash rate theo thời gian thực trên mọi phiên bản đang hoạt động, với hai tín hiệu bổ trợ có thể kích hoạt cảnh báo on-call:
Hai tín hiệu bắt hai kiểu lỗi khác nhau. Ngưỡng cứng bắt hiện tượng trôi chậm: nếu mỗi bản phát hành làm crash rate nhích lên một chút thì từng bước đều có vẻ bình thường so với mức nền gần đây, nhưng sau một năm tỷ lệ có thể tăng âm thầm. Cảnh báo xu hướng bắt trường hợp ngược lại, tức regression đột ngột, từ sớm trước khi đủ lớn để vượt ngưỡng.
Khi một tín hiệu kích hoạt, kỹ sư on-call được báo ngay, xem báo cáo Firebase Crashlytics để xác định các crash gây bất thường rồi gọi nhóm phụ trách khu vực bị ảnh hưởng. Sau đó nhóm đi theo khung quyết định ba bước, từ rẻ nhất tới đắt nhất:
Tắt feature flag liên quan. Nếu crash gắn với tính năng nằm sau flag, tắt flag chặn người dùng mới gặp lỗi ngay mà không cần build mới, và đây là biện pháp giảm thiểu nhanh nhất.
Áp dụng bản sửa phía server. Nếu không có flag che đường chạy bị ảnh hưởng, nhóm tìm đòn bẩy phía server như cập nhật phản hồi API, đổi giá trị cấu hình hay giới hạn một dependency backend; thay đổi có hiệu lực mà không cần build app mới được ưu tiên.
Phát hành hotfix. Nếu hai cách trên không khả thi, nhóm cân nhắc có nên làm hotfix ngoài chu kỳ hay không, dựa trên tiêu chí: mức quan trọng nghiệp vụ của luồng bị ảnh hưởng, độ nghiêm trọng của crash, tác động tới người dùng và thời gian tới bản phát hành định kỳ kế tiếp. Sau hotfix bắt buộc có post-mortem.
Post-mortem không chỉ ghi lại điều gì sai mà còn chốt các hành động cụ thể để bịt lỗ hổng ở lớp phòng ngừa, như thêm lint rule chặn cùng mẫu code, đặt tính năng tương tự sau flag hoặc cải thiện độ phủ test cho đường code bị ảnh hưởng.
Triage tự động và quan sát chuyên sâu
Việc tạo ticket tự động ở GEA và production là một pipeline triage duy nhất đi theo bản phát hành từ GEA vào production. Ở production, chạy song song với giám sát thời gian thực, pipeline tạo ticket cho crash vượt ngưỡng tối thiểu. Crash được đánh giá theo loại, tác động tới người dùng và khả năng xử lý; crash lẻ tẻ, đặc thù thiết bị mà nhóm không xử lý được sẽ được theo dõi nhưng không tạo ticket. Với crash đủ điều kiện, ticket được chuyển tới nhóm sở hữu kèm SLA theo mức nghiêm trọng: Urgent, High, Medium hoặc Low. Mức ưu tiên ban đầu được đặt tự động theo crash rate và tác động người dùng, và các nhóm có thể điều chỉnh theo mức quan trọng nghiệp vụ của tính năng.
Firebase Crashlytics là công cụ giám sát crash chính, nhưng một số crash khó chẩn đoán: stack trace không dùng được, crash native từ thư viện bên thứ ba thiếu debug symbol, hoặc lỗi chỉ xuất hiện ở cấu hình thiết bị cụ thể. Grab xử lý theo hai cách. Thứ nhất, dùng tính năng export sang BigQuery của Crashlytics để sở hữu một bản sao dữ liệu crash, đã được pseudonymize và xử lý theo chính sách bảo vệ dữ liệu của Grab. Bản sao này cho phép truy vấn SQL trên thuộc tính thiết bị, phiên bản app và metadata phiên để lộ ra các mẫu mà từng báo cáo riêng lẻ không thấy, đồng thời xây dashboard nội bộ phân tách theo loại crash, hạng thiết bị hoặc phiên bản.
Thứ hai, mỗi phiên crash được làm giàu bằng metadata tùy biến gắn trực tiếp vào Crashlytics. Ba thuộc tính hữu ích nhất:
Cùng với structured log và breadcrumb, các thuộc tính này tạo thành dấu vết sự kiện dẫn tới crash, thường là tín hiệu có ý nghĩa duy nhất khi stack trace không đủ.
Điểm chính
Ổn định ứng dụng là kết quả tích lũy của phòng thủ nhiều lớp: lint và test chặn code xấu ở cổng merge, QA và GEA bắt phần lọt lưới, staged rollout giới hạn phạm vi ảnh hưởng, còn on-call cùng triage tự động khép vòng với những gì production phơi bày.
Nguyên tắc chung của mọi lớp là shift-left: crash được bắt càng sớm thì càng rẻ, nhỏ và ít gây gián đoạn khi sửa.
Khi ứng phó, thứ tự ưu tiên đi từ rẻ tới đắt: tắt feature flag, sửa phía server, rồi mới tới hotfix, và mỗi hotfix phải kèm post-mortem để thắt chặt lớp phòng ngừa.
Với crash khó chẩn đoán, dữ liệu export sang BigQuery và metadata tùy biến trên Crashlytics cung cấp manh mối khi stack trace không đủ.
AI làm code được viết nhanh hơn; phòng thủ nhiều lớp là điều giúp tốc độ đó an toàn, và ổn định không có nghĩa là không còn vấn đề mở mà là biết vấn đề nào mình sở hữu, vấn đề nào đang theo dõi.
Nguồn tham khảo
Các nguồn mà bài viết này dựa vào.
- App stability at scale with a layered defense (mở trong tab mới) — Grab Engineering