Rò rỉ KV cache giữa các request khi phục vụ LLM: bài học từ Workers AI
Trong bài này
Từ ngày 27 tháng 8 năm 2026, mô hình GLM-5.3 trên Workers AI (@cf/zai-org/glm-5.3) gặp lỗi cô lập giữa các khách hàng: một số phản hồi chứa dữ liệu từ yêu cầu của khách hàng khác gửi tới cùng mô hình ngay trước đó. Lỗi là kết quả của hai vấn đề chồng lên nhau: cấu hình triển khai SGLang chưa khớp và một bug trong cách SGLang xử lý các yêu cầu quá dài ở chế độ disaggregated prefill/decode. Sự cố đã được khắc phục và mô hình được khôi phục vào ngày 9 tháng 9, đồng thời được công bố phối hợp với bài của nhóm SGLang.
Phạm vi ảnh hưởng và diễn biến
Nhà nghiên cứu Gadi Evron của Knostic báo cáo qua chương trình HackerOne vào ngày 8 tháng 9. Theo báo cáo, các prompt rất dài gửi tới mô hình đôi khi nhận lại văn bản thuộc phiên của người dùng khác. Cloudflare tái hiện lỗi vào sáng hôm sau và đưa mô hình ngoại tuyến trong vòng 40 phút kể từ khi tuyên bố sự cố. Tổng cộng 155 phản hồi bị ảnh hưởng, đều là phản hồi cho các prompt dài hơn 681,280 token. Sau khi loại trừ các lần thử nghiệm của chính Cloudflare và của nhà nghiên cứu, các yêu cầu còn lại phù hợp về thời điểm và khối lượng với việc dùng long-context thông thường, và không có bằng chứng về khai thác có chủ ý. Không có mô hình nào khác trên Workers AI bị ảnh hưởng.
Các mốc chính của sự cố:
Nguyên nhân kỹ thuật
Kích thước pool không phải là giá trị cấu hình: SGLang tự tính khi khởi động từ lượng bộ nhớ GPU còn lại sau khi nạp trọng số. Độ dài ngữ cảnh của mô hình là một giá trị cấu hình riêng, và không có gì buộc hai giá trị này khớp nhau.
Vấn đề thứ hai là bug của SGLang trong chế độ disaggregated. Khi prompt dài hơn pool, scheduler đánh dấu request là bị từ chối và thay prompt bằng một placeholder một token để request chạy qua cơ chế batch bình thường mà không cấp phát bộ nhớ thật. Ở triển khai một node, client nhận được lỗi. Ở chế độ disaggregated, các admission queue của cả prefill và decode kiểm tra request đã finished chưa, chứ không kiểm tra có bị rejected không, nên request bị từ chối vẫn được coi là còn sống.
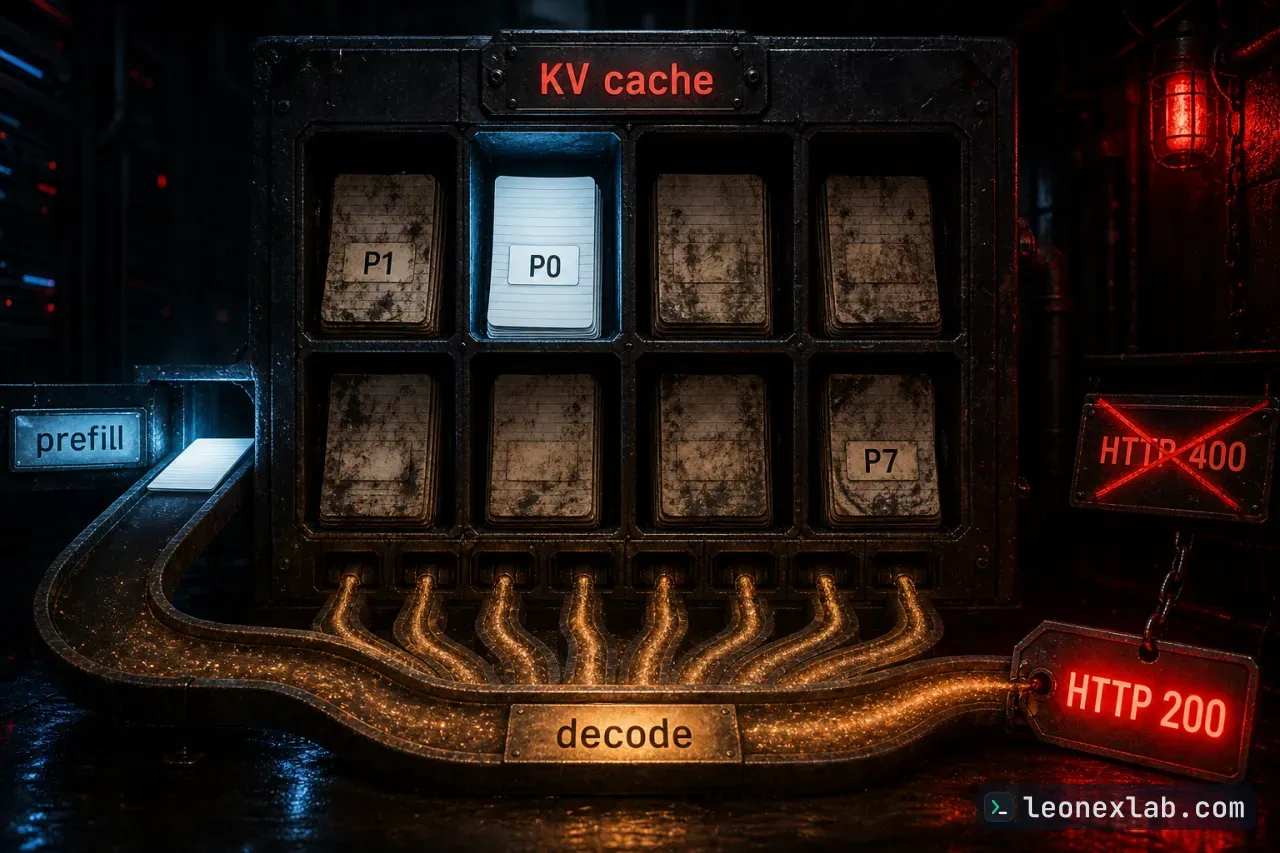
Router báo cho decode node độ dài prompt, và decode giữ chỗ 8 KV page cho request.
Prefill admission queue nhận request bị từ chối vì finished() vẫn trả về False.
Prefill chạy forward pass tầm thường trên một token placeholder, gửi một page KV sang decode và báo chuyển xong.
Decode chấp nhận bàn giao, bắt đầu sinh phản hồi và attention đọc cả 8 page đã giữ chỗ.
Chỉ page P0 do request này ghi. Các page P1 đến P7 vẫn chứa dữ liệu của các request trước, gồm prompt và phần sinh dở của người dùng khác.
Client nhận HTTP 200 thay vì HTTP 400, với phản hồi mạch lạc chứa nội dung từ các page KV của người khác.
Biện pháp khắc phục
Sau khi tắt mô hình, đội ngũ thực hiện hai nhóm sửa đổi trước khi mở lại.
Củng cố hệ thống và phối hợp với SGLang
Bug này thuộc nhóm lỗi an toàn bộ nhớ KV cache, nơi một page bị giải phóng, tái sử dụng hoặc đọc trong khi vẫn có bên khác nắm quyền truy cập. Có hai nguyên nhân phổ biến: vòng đời page trong một node, khi nhiều tác vụ cùng giữ một page, và race condition giữa các node, khi request bị hủy trong lúc prefill vẫn đang ghi KV sang decode qua RDMA mà các lần ghi đã gửi không thể thu hồi. Sau sự cố, Cloudflare đã thực hiện các việc sau trên mọi triển khai disaggregated trong production.
Một ngày sau sự cố, Cloudflare họp với các maintainer SGLang tại RadixArk. Hai bên thống nhất RadixArk sẽ điều tra các race condition đã báo cáo, đưa ý tưởng kiểm tra tính toàn vẹn lên upstream và xây các bài test tái hiện cho nhóm lỗi này. Bản vá cho sự cố được phát hành trong SGLang v0.5.20, cùng các bản tiếp nối ở v0.5.21 và v0.5.22. Một số thay đổi đã vào upstream gồm:
Khuyến nghị cho các đơn vị vận hành SGLang
Với những ai chạy SGLang ở chế độ disaggregated prefill/decode, Cloudflare khuyến nghị cập nhật phụ thuộc SGLang lên v0.5.22 trở lên và thực hiện các bước sau.
Về dài hạn, hướng được theo đuổi là phát hiện ngay lúc đọc việc một request sắp attend trên page không thuộc về nó và làm lỗi riêng request đó thay vì trả dữ liệu của người khác. Bản prototype gắn cho mỗi KV page vật lý một tag đổi mỗi khi page được cấp phát lại, mỗi request ghi lại các tag mong đợi, và ánh xạ được kiểm tra trước khi decode đọc cache; trong thử nghiệm, chi phí dưới 1% về throughput và tail latency. Prototype bị tắt do vấn đề độ tin cậy và gắn với backend attention cụ thể, nên Cloudflare đang cùng đội SGLang xây phiên bản production hoạt động với mọi mô hình. Song song, Cloudflare hướng kinh nghiệm formal verification sang các engine chuyển KV cache, bắt đầu bằng việc mô hình hóa và chứng minh an toàn của giao thức chuyển KV cache dựa trên RDMA.
Điểm chính
Từ 27 tháng 8 đến 9 tháng 9, 155 phản hồi của GLM-5.3 cho prompt dài hơn 681,280 token có thể chứa dữ liệu của khách hàng khác; không có bằng chứng về khai thác có chủ ý.
Nguyên nhân là hai vấn đề chồng nhau: KV pool của prefill nhỏ hơn cửa sổ ngữ cảnh, và SGLang không hủy request bị từ chối ở chế độ disaggregated mà vẫn chuyển cache cũ sang decode.
Cách khắc phục gồm nới pool lên khoảng 2.04 triệu token và vá engine để loại request bị từ chối trước khi bàn giao.
Chỉ GLM 5.3 bị ảnh hưởng; các bản sửa upstream nằm trong SGLang v0.5.22 và nhà vận hành được khuyến nghị cập nhật.
Hướng dài hạn là kiểm tra quyền sở hữu page tại thời điểm đọc và chứng minh hình thức giao thức chuyển KV cache.
Nguồn tham khảo
Các nguồn mà bài viết này dựa vào.